llm
서빙 4편. 멀티 모델 - LRU 캐시와 Triton 위임
한 서비스가 여러 모델을 나눠 쓰는 구조와, 무엇을 메모리에 올려둘지 정하는 캐시 정책, 그리고 비용과 지연 사이의 맞바꿈
2026.08.16 · 33 min read
1편에서 요청 하나가 API server부터 GPU 안의 model worker까지 어떻게 내려가는지 봤고, 2편에서 그 요청들을 정적 배치로 묶었고, 3편에서 vLLM에 그 배치를 맡기면서 서비스 인프라·비즈니스 로직·모델 실행이라는 세 겹 구조를 그렸습니다. 지금까지 만든 서버는 이 세 겹 중 어디에 있든 상대하는 모델이 늘 하나였습니다.
실제 서비스는 모델을 하나만 올려두지 않습니다. 감성분석, 스팸탐지, 이미지 분류처럼 성격이 다른 모델 여러 개를 같은 서비스가 나눠 씁니다. 모델마다 서버를 따로 두면 무슨 일이 생기는지, 한 서버가 여러 모델을 안전하게 나눠 쓰려면 무엇을 결정해야 하는지가 이번 편의 주제입니다.
정리한 결정 셋입니다. ModelManager는 어떤 모델을 메모리에 올려둘지 LRU 캐시로 정하고, ModelEngine은 프레임워크별로 다른 워커를 만들어내고, Triton은 그 결정 중 실행 자체를 통째로 다른 서버에 넘깁니다. 마지막에는 이 구조를 비용에 맞출지 지연에 맞출지, 두 가지 설계로 가르겠습니다.
세 결정 모두 겉보기엔 서로 다른 코드 조각처럼 보이지만, 밑에 깔린 질문은 하나입니다. 한정된 자원 앞에서 무엇을 우선할 것인가. 이 질문이 캐시 정책이 되기도 하고, 워커 클래스 선택이 되기도 하고, 아예 다른 서버로의 위임이 되기도 하는 과정을 순서대로 따라가겠습니다.
1부. 모델 하나에 서버 하나가 안 되는 이유
1.1 GPU 사용률 10, 20, 5, 80
모델마다 서버를 따로 두는 구성부터 보겠습니다. 감성분석 서버, 스팸탐지 서버, 이미지 분류 서버, 그리고 임베딩 서버 하나. 넷을 나란히 세워두고 GPU 사용률을 재면 이렇게 나옵니다.
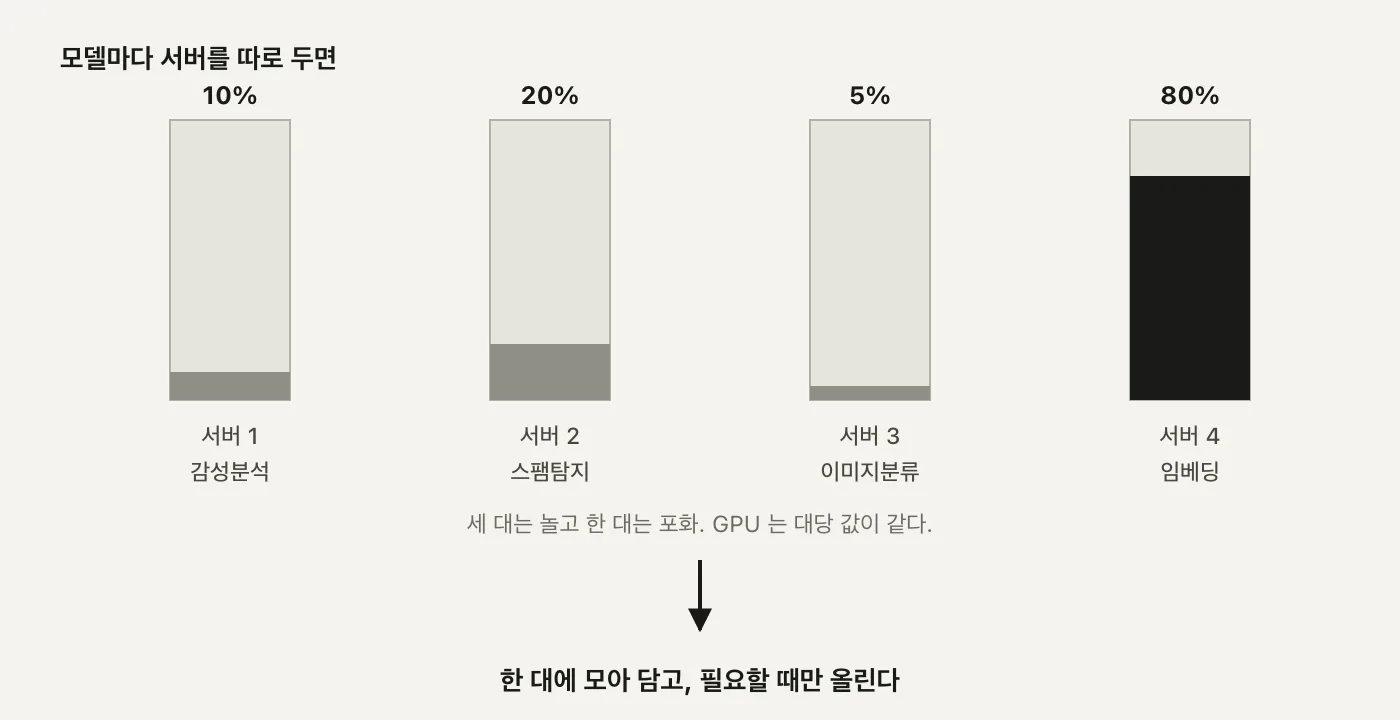
10%, 20%, 5%짜리 서버는 GPU를 거의 놀리고, 80%짜리는 조금만 더 몰리면 큐가 쌓입니다. 서버 대수를 GPU 대수만큼 사놓고 이 불균형을 방치하는 건 돈 낭비입니다. 답은 간단해 보입니다. 모델 넷을 서버 한 대에 몰아넣으면 됩니다.
이런 불균형은 대개 의도적으로 생기지 않습니다. 팀마다 모델을 하나씩 만들고 자기 서버를 띄우다 보면 자연스럽게 이렇게 흩어집니다.
"몰아넣는다"가 2편의 배칭과 헷갈릴 수 있어 미리 갈라두겠습니다. 2편의 배칭은 같은 모델에 온 요청 여럿을 한 배치로 묶는 이야기였고, 이번 편은 서로 다른 모델을 한 프로세스가 나눠 쓰는 이야기라 애초에 같은 배치로 묶일 수 없습니다. 여기서 공유하는 건 배치가 아니라 GPU라는 자원 그 자체입니다.
몰아넣는 순간 질문 셋이 따라오고, 답도 하나씩 붙습니다.
- 프레임워크가 다르면 어떻게 하나 - 감성분석은 Transformers, 이미지 분류는 TorchVision을 쓸 수 있습니다. 이 차이를 API 바깥으로 감춰야 클라이언트가 프레임워크를 신경 쓰지 않습니다. → 프레임워크 교차 지원
- API를 어떻게 통일하나 - 클라이언트는
/predict에model_id만 넘기면 되고, 그 뒤에서 어떤 프레임워크가 돌아가는지는 서버의 책임입니다. → 통일된 API - 자원을 어떻게 관리하나 - 넷을 한꺼번에 다 올려두면 원래 문제로 되돌아갑니다. 필요할 때만 올리고, 자리가 없으면 가장 안 쓰는 것부터 내려야 합니다. → 자원 관리(필요할 때 로드 + LRU 축출)
이 세 가지가 이번 편에서 만드는 구조의 설계 목표입니다. 왜 중요한가 - 서버를 합치는 것 자체는 인프라 작업이지만, 합친 뒤에도 안전하게 돌아가게 만드는 건 소프트웨어 설계 문제입니다. 마지막 목표가 이번 편의 절반을 차지하는데, 프레임워크를 감추고 API를 통일하는 건 한 번 설계하면 끝나지만 자원 관리는 요청마다 매번 다시 판단해야 하는 문제라서입니다.
1.2 다섯 컴포넌트와 서빙 일곱 단계
세 목표를 만족하려고 컴포넌트를 다섯으로 나눕니다.
- API server - 요청을 받는 창구.
/predict로 들어오는 모든 모델의 요청을 같은 형식으로 받습니다. - Model manager - 이 구조의 중심. 어떤 모델이 지금 메모리에 있는지 캐시로 들고 있고, 캐시가 차면 무엇을 뺄지 정합니다.
- Model store - 메타데이터 창고. 모델 자체가 아니라 "이 모델은 어떤 프레임워크고 이름이 뭔지"를 알려줍니다.
- Model engine - 워커 팩토리. 메타데이터의 프레임워크 값을 보고 알맞은 워커를 만듭니다.
- Model worker - 실제 추론이 일어나는 자리. 프레임워크마다 코드가 다릅니다.
다섯 중 상태를 실제로 들고 있는 건 Model manager 하나뿐입니다. Model store는 파일 하나를 읽어 그대로 들고 있을 뿐 바뀌지 않고, Model engine은 요청받은 대로 객체를 만들어 넘길 뿐이고, Model worker는 자기가 언제 캐시에서 빠질지도 모릅니다. "지금 무엇이 메모리에 있는가"라는 시시각각 바뀌는 유일한 상태가 Model manager에 모여 있어서 이 컴포넌트가 중심이 됩니다.
이름만 나열하면 순서가 안 잡히니, 요청 하나가 도는 일곱 단계로 이어보겠습니다.
1) 클라이언트 요청           POST /predict {model_id, input_data}
2) 모델 조회                 Model manager가 캐시를 확인
3) (캐시 미스면) 메타데이터 조회  Model store에서 프레임워크·이름 확인
4) 워커 생성                 Model engine이 프레임워크에 맞는 워커를 생성
5) 워커 등록                 캐시가 차 있으면 LRU로 하나 축출 후 등록
6) 추론                     Model worker가 실제로 forward
7) 응답                     결과를 클라이언트에 반환
2번에서 캐시 히트면 3-5번은 건너뛰고 바로 6번으로 갑니다. 서버를 막 띄운 시점에는 캐시가 비어 있으니 첫 요청은 무조건 3-5번을 전부 거치고, 그다음부터 같은 모델이 다시 들어오면 캐시 히트로 바로 6번입니다.
3번의 메타데이터가 실제로 어떤 모양인지 보겠습니다.
{
  "id": "550e8400-e29b-41d4-a716-446655440000",
  "name": "distilbert-base-uncased-finetuned-sst-2-english",
  "type": "text",
  "framework": "transformers",
  "version": "1.0.0"
}
이 한 줄이 4번(어떤 워커 클래스를 만들지)과 6번(어떤 코드로 추론할지)을 전부 결정합니다. 이 메타데이터를 관리하는 게 Model store고, 실제 서비스라면 원격 데이터베이스에 있을 정보를 여기서는 로컬 JSON 파일(config/models.json) 하나로 대신합니다.
다섯 컴포넌트를 실제 파일로 옮기면 이렇습니다.
| 파일 | 줄 수 | 역할 |
|---|---|---|
server.py |
43 | API 엔드포인트 |
store.py |
27 | 메타데이터 조회 |
manager.py |
42 | 캐시·생명주기 |
engine.py |
27 | 워커 팩토리 |
worker.py |
144 | 프레임워크별 실제 추론 |
왜 중요한가 - worker.py 한 파일이 나머지 네 파일(139줄)을 합친 것보다도 큽니다. 캐시를 관리하고 팩토리 노릇을 하고 메타데이터를 읽는 코드는 전부 얇습니다. 진짜 복잡도는 "프레임워크마다 추론 코드가 다르다"는 사실 하나에 몰려 있고, 그게 그대로 파일 크기로 드러납니다.
이 다섯 컴포넌트는 1편 1.2절의 여섯 컴포넌트와 이름이 겹치지만, 그쪽은 CPU·GPU 작업 분리가 문제였고 이쪽은 같은 프로세스 안에서 어떤 모델을 메모리에 남겨둘지를 결정하는 문제입니다.
2부. ModelManager - 무엇을 메모리에 올려둘 것인가
2.1 OrderedDict 하나로 만든 LRU
Model manager의 역할은 한 문장으로 줄일 수 있습니다. 어떤 모델을 RAM/VRAM에 올려둘 것인가. 구현은 Python OrderedDict 하나로 끝납니다.
# manager.py — get_model_worker() (14-39행)
def get_model_worker(self, model_id: str) -> Optional[ModelWorker]:
    if model_id in self.model_cache:
        self.model_cache.move_to_end(model_id)          # 캐시 히트 - 순서 갱신
        return self.model_engine.get_worker(model_id)

    model_metadata = self.model_store.get_model(model_id)
    if not model_metadata:
        return None

    if len(self.model_cache) >= self.max_models:
        id, model_worker = self.model_cache.popitem(last=False)  # 가장 오래 안 쓴 것
        self.model_engine.delete_worker(id)

    self.model_cache[model_id] = \
        self.model_engine.create_worker(model_metadata)
    return self.model_cache[model_id]
max_models 기본값은 2입니다. 캐시 히트면 move_to_end로 그 항목을 맨 뒤로 보내 "방금 썼다"고 표시하고, 캐시 미스인데 정원이 찼으면 popitem(last=False)로 맨 앞(가장 오래 안 쓴 것)을 빼서 delete_worker로 지웁니다.
변수 이름으로 id를 쓴 것도 눈에 띕니다. 파이썬 내장 함수 id()를 이 스코프 안에서 가리는 셈인데, 다음 줄에서 바로 쓰고 스코프가 끝나니 실질적인 문제는 없지만 한 번은 눈에 걸리는 지점입니다.
max_models = 2로 세 번 호출하는 과정을 3단으로 그리면 이렇습니다.
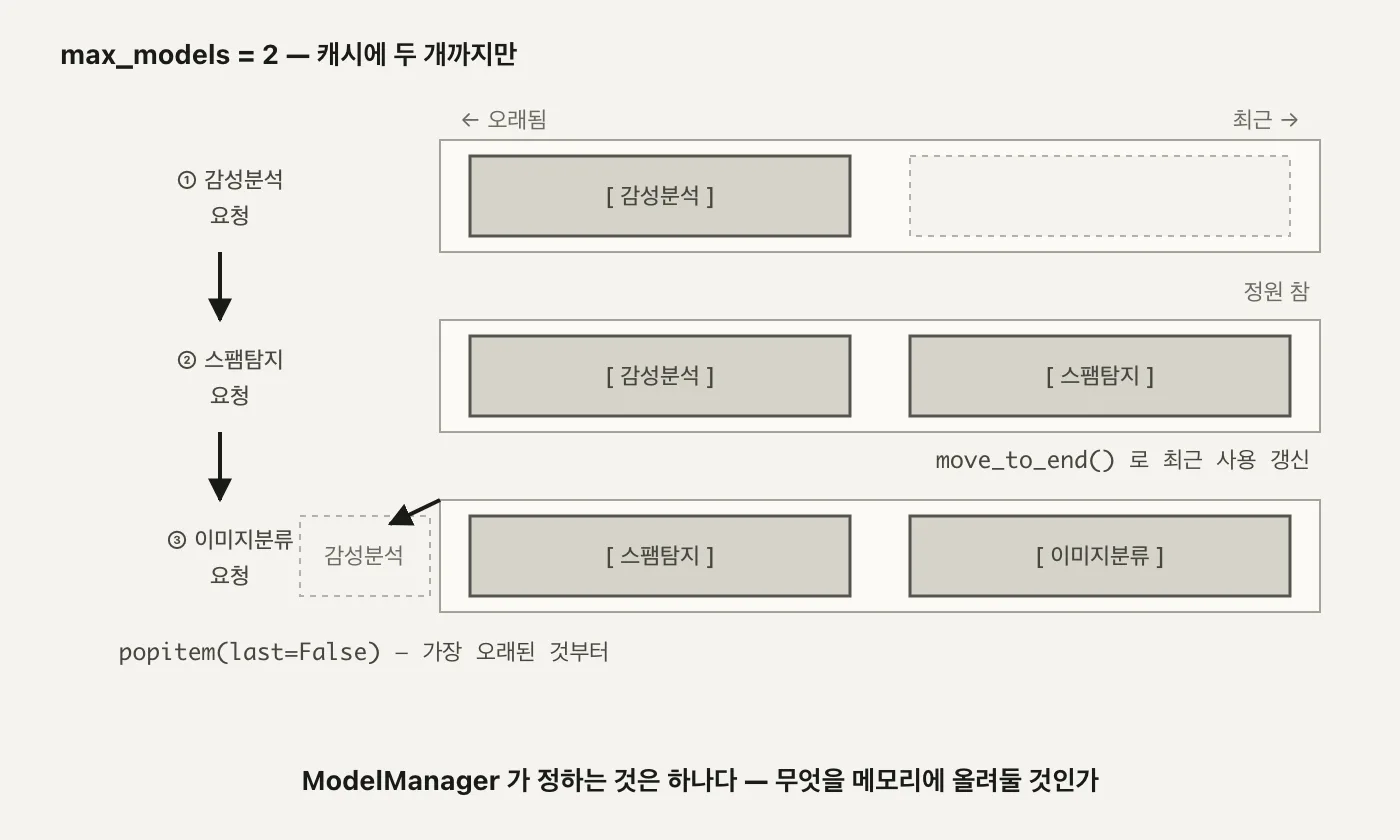
캐시 히트일 때 반환값이 self.model_cache[model_id]가 아니라 self.model_engine.get_worker(model_id)라는 점도 눈여겨볼 만합니다. model_cache는 캐시 상태(누가 최근에 쓰였는지)만 들고 있고, 워커 객체 자체를 실제로 보관하는 건 Model engine입니다. "무엇을 남길지"를 결정하는 장부와 "그 객체를 실제로 들고 있는" 저장소가 분리돼 있는 셈입니다.
dict 대신 OrderedDict를 쓰는 이유도 여기서 나옵니다. 일반 dict는 삽입 순서는 기억해도 "방금 다시 조회했다"는 사건을 반영할 방법이 없습니다. move_to_end로 캐시 히트마다 순서를 갱신해야, popitem(last=False)가 뽑는 맨 앞이 진짜로 "가장 오래 안 쓴" 항목이 됩니다.
무엇을 하는가 - 캐시 히트는 순서만 갱신하고, 캐시 미스는 정원 초과 시 하나를 빼고 새로 만듭니다. 왜 중요한가 - 이 캐시가 이 구조 전체에서 유일하게 "누구를 메모리에 남길까"를 결정하는 지점입니다. 나머지 컴포넌트는 전부 이 결정을 따라갈 뿐입니다.
2.2 framework 문자열 하나로 갈리는 경로
캐시 미스로 워커를 새로 만들어야 할 때, 그 워커의 실체를 정하는 게 Model engine입니다.
# engine.py — create_worker() (14-24행)
def create_worker(self, model_metadata: ModelMetadata) -> ModelWorker:
    if model_metadata.id not in self.workers:
        if model_metadata.framework == "transformers":
            self.workers[model_metadata.id] = TransformerWorker(model_metadata)
        elif model_metadata.framework == "torchvision":
            self.workers[model_metadata.id] = TorchVisionWorker(model_metadata)
        elif model_metadata.framework == "triton":
            self.workers[model_metadata.id] = TritonWorker(model_metadata)
    return self.workers[model_metadata.id]
model_metadata.framework라는 문자열 하나가 if/elif 사슬을 타고 완전히 다른 클래스를 만들어냅니다. Model engine은 워커 팩토리라서, 새 프레임워크를 지원하려면 이 사슬에 분기 하나와 워커 클래스 하나만 추가하면 됩니다. ModelWorker가 _load_model·predict 두 메서드만 강제하는 추상 클래스라서 가능한 일이고, 캐시 로직도 API 엔드포인트도 건드릴 필요가 없습니다.
config/models.json에 등록된 모델 넷이 이 분기를 전부 지나갑니다.
| 모델 | framework | 용도 |
|---|---|---|
distilbert-base-uncased-finetuned-sst-2-english |
transformers | 감성분석 |
mrm8488/bert-tiny-finetuned-sms-spam-detection |
transformers | 스팸탐지 |
pytorch/vision:mobilenet_v2 |
torchvision | 이미지 분류 |
densenet_onnx |
triton | 이미지 분류(원격) |
넷이 프레임워크 셋, 용도 둘에 걸쳐 있습니다. 1.1절에서 목표로 세운 "프레임워크 교차 지원"이 이 표 하나로 구체화된 셈입니다.
TransformerWorker의 추론 코드(worker.py:27-44)는 토크나이즈 → torch.no_grad() → softmax 세 단계로 짧습니다.
def predict(self, input_data: Any) -> Dict[str, Any]:
    inputs = self.tokenizer(input_data, return_tensors="pt",
                             padding=True, truncation=True)
    with torch.no_grad():
        outputs = self.model(**inputs)
    predictions = torch.softmax(outputs.logits, dim=-1)
    return {"predictions": predictions.tolist()}
"This movie was great! I really enjoyed it."를 실제로 호출하면 [0.0001, 0.9999](부정, 긍정)가 나오고, 스팸탐지도 같은 경로를 타지만 모델이 달라 [0.9324, 0.0676]이 나옵니다. 첫 호출은 가중치 로딩(캐시 미스)에서 끝나고 두 번째부터는 캐시를 재사용합니다.
TorchVisionWorker(worker.py:46-73)는 토크나이저 대신 transforms.Compose로 이미지를 리사이즈·정규화하고 torch.hub로 mobilenet_v2(13.6MB)를 받아오지만, torch.no_grad()·softmax 골격은 같습니다.
TritonWorker(worker.py:75-145)는 골격 자체가 다릅니다. _load_model과 predict 둘 다 로컬에서 torch.no_grad()를 부르지 않는데, 그 이야기는 3부에서 이어가겠습니다. 서버는 포트 8001에서 이 넷을 전부 같은 /predict 엔드포인트로 받습니다.
2.3 셋을 불러도 loaded_models 는 둘
max_models = 2가 코드 상수로만 존재하는지 실제로 확인해보겠습니다. 감성분석 → 스팸탐지 → 이미지분류 순서로 호출한 뒤, 그때그때 /models로 캐시 상태를 봅니다.
/models 엔드포인트는 키가 두 개입니다. available_models는 Model store가 아는 전체 목록이라 고정이고, loaded_models는 지금 Model manager 캐시에 실제로 올라와 있는 것만 걸러낸 목록이라 요청마다 바뀝니다.
세 번 호출한 결과를 이어보면 이렇습니다.
호출 전            loaded_models: {}
감성분석 요청 후    loaded_models: { 550e8400: distilbert-base-...-sst-2-english }
스팸탐지 요청 후    loaded_models: { 550e8400: distilbert-..., 6ba7b810: bert-tiny-spam }     ← 정원(2) 참
이미지분류 요청 후  loaded_models: { 6ba7b810: bert-tiny-spam, 7c9e6679: mobilenet_v2 }       ← popitem(last=False)로 감성분석 축출
셋을 다 불렀는데도 loaded_models 길이는 항상 둘이고, 맨 처음 불렀던 감성분석이 맨 먼저 빠집니다. 2.1절의 3단 그림이 이 호출 세 번의 실제 결과입니다.
이 구조를 검증하는 테스트도 있습니다. pytest tests/test_models.py -v를 처음 돌리면 **1 failed, 6 passed in 54.55s**가 나옵니다. FastAPI TestClient로 네 프레임워크(Transformers×2, TorchVision, Triton) 전체를 검증하는 통합 테스트입니다.
| 테스트 | 검증 내용 |
|---|---|
test_list_models |
/models 키 확인 |
test_sentiment_model |
감성분석 라벨 비교 |
test_spam_model |
스팸탐지 확인 |
test_image_model |
TorchVisionWorker로 cat1.jpg 분류 |
test_image2_triton_model |
TritonWorker 원격 분류 - Triton 없으면 실패 |
test_invalid_model_id |
존재하지 않는 model_id → 404 |
test_model_cache |
3종 연속 호출 후 loaded_models 개수 확인 |
통과한 여섯 개 안에 test_model_cache가 있고, 실패한 하나가 test_image2_triton_model입니다. Triton 서버가 아직 없어서 예정된 실패고, 이 실패를 없애는 게 3부의 내용입니다.
다만 test_model_cache를 열어보면 200 응답과 loaded_models 길이만 단언하고, 정확히 어느 모델이 빠졌는지는 확인하지 않습니다. 상한 2가 지켜지는 것만 볼 뿐 "가장 오래 안 쓴 것"이라는 정책 자체가 맞는지는 이 테스트만으로는 알 수 없습니다.
2.4 캐시에서 지웠는데 VRAM이 안 줄어든다
popitem으로 캐시에서 빼고 delete_worker까지 불렀는데, nvidia-smi를 보면 VRAM 숫자가 그대로인 경우가 있습니다. 원인이 두 겹입니다.
- 지역 변수가 아직 붙들고 있다 -
popitem()이 돌려준 값이id, model_worker = ...로 지역 변수에 담기는데, 함수가 끝날 때까지 이 변수가 살아 있어 참조 카운트가 0이 되지 않습니다. 객체가 안 죽었으니 GPU 메모리도 그대로입니다. - 죽어도 PyTorch가 돌려주지 않는다 - 참조가 사라져 객체가 소멸해도, PyTorch의 caching allocator는 한번 확보한 VRAM을 재사용하려고 쥐고 있을 뿐 OS에 반환하지 않습니다.
첫 번째는 파이썬의 참조 카운트 문제고, 두 번째는 PyTorch가 자체 관리하는 메모리 풀 문제라 층이 다릅니다. 파이썬 쪽만 고쳐도 allocator가 VRAM을 쥐고 있으면 nvidia-smi 숫자는 그대로입니다. gc.collect()로 순환 참조(워커가 자기 자신을 가리키는 콜백을 들고 있는 경우 등)까지 정리해야, 뒤이은 torch.cuda.empty_cache()가 회수할 게 남아 있는 상태가 됩니다.
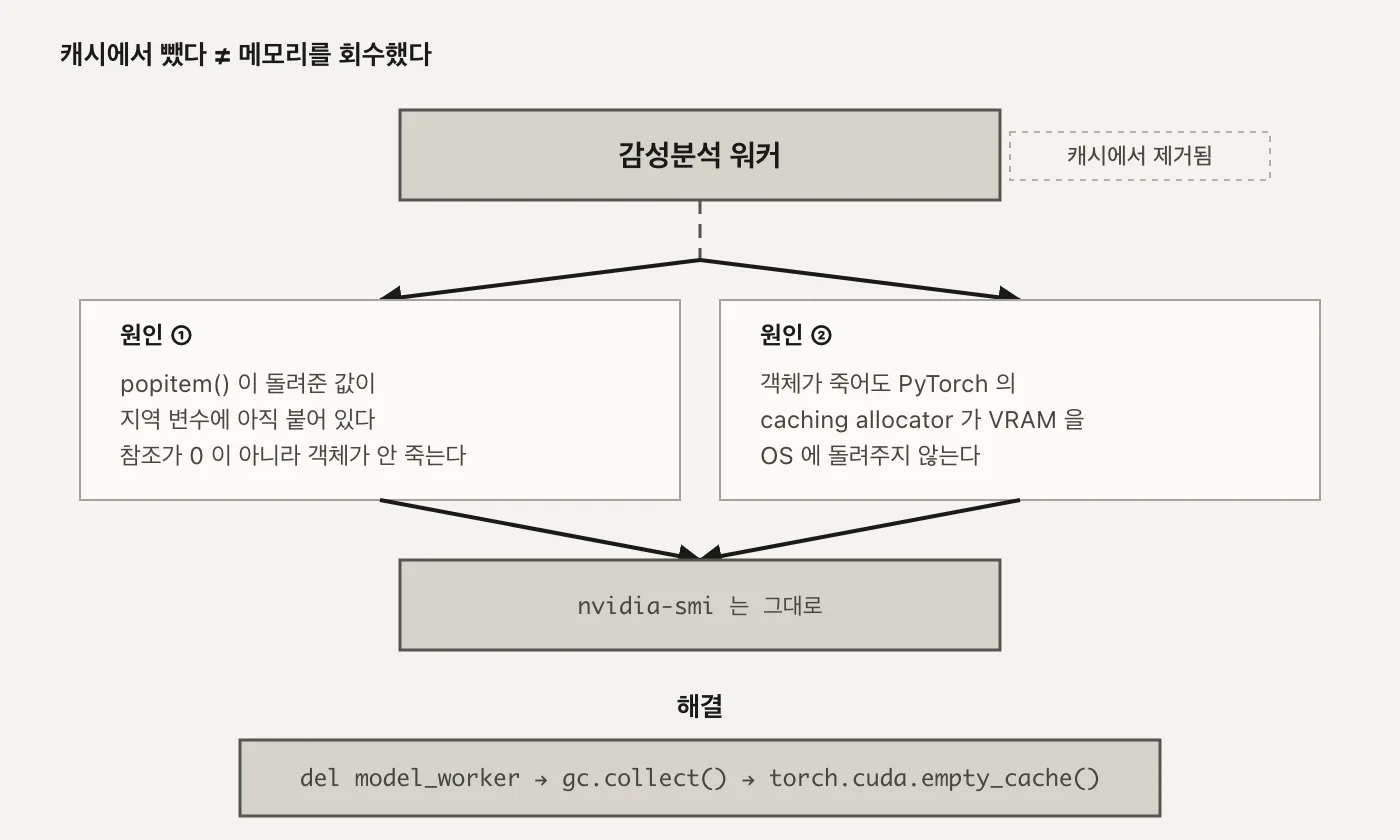
해법은 셋을 다 하는 것입니다. 2.1절의 그 eviction 블록(popitem → delete_worker) 뒤에 세 줄을 더합니다.
del model_worker                      # 마지막 참조 제거
gc.collect()                          # 순환 참조까지 정리
if torch.cuda.is_available():
    torch.cuda.empty_cache()          # allocator가 쥔 VRAM 반환
왜 중요한가 - "모델 객체를 버리는 것"과 "메모리를 실제로 회수하는 것"은 다른 문제입니다. max_models를 아무리 정확히 지켜도 del과 empty_cache()를 빠뜨리면 캐시 밖에서 VRAM이 계속 쌓이고, 캐시 상한을 지켰는데도 OOM이 나는 전형적인 원인이 됩니다.
del model_worker에는 부수 효과도 있습니다. 3부에서 볼 TritonWorker는 __del__에서 원격 unload를 호출하는데, del이 없으면 이 소멸자 호출이 함수가 끝날 때까지 밀립니다.
이 절에서 믿을 수 있는 지표는 loaded_models 같은 카운터가 아니라 nvidia-smi가 보여주는 실제 하드웨어 숫자입니다. torch.cuda.empty_cache()도 만능은 아니라, 더는 안 쓰는데도 쥐고 있던 블록만 돌려줄 뿐 다음 모델 로드에서 allocator는 다시 그만큼을 쥡니다. "당장 회수"를 위한 것이지 캐싱 자체를 막는 스위치가 아닙니다.
3부. Triton에 위임하기
3.1 로드가 HTTP 요청이 되는 순간
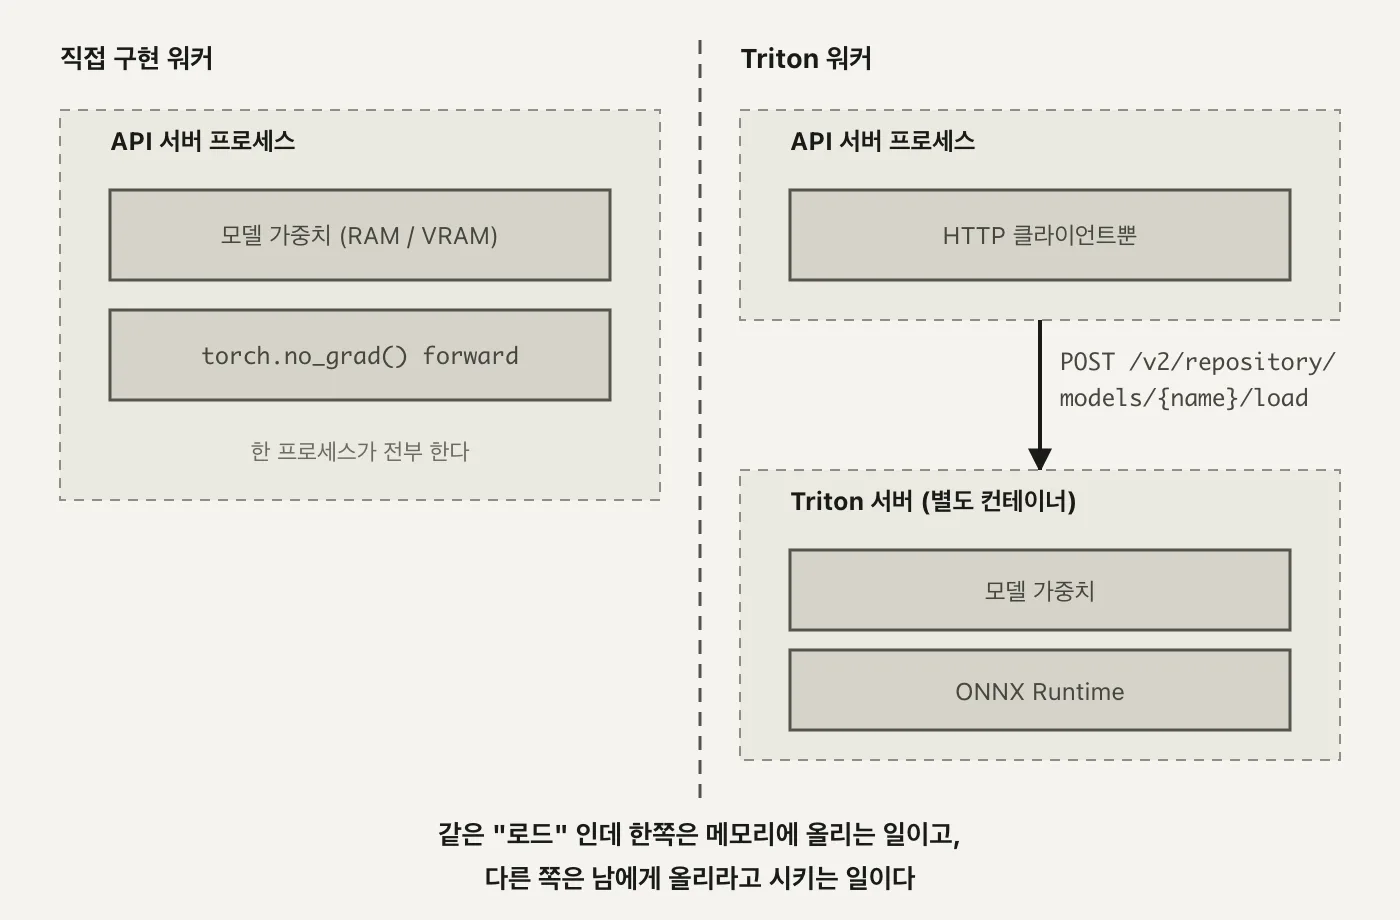
지금까지의 두 워커(TransformerWorker, TorchVisionWorker)는 이 프로세스 안에서 직접 forward를 돌리지만, TritonWorker는 모델 가중치도 추론 연산도 이 프로세스 안에 없습니다.
# worker.py — TritonWorker
class TritonWorker(ModelWorker):
    def __init__(self, model_metadata):
        self.triton_url = "0.0.0.0:8009"
        self.client = httpclient.InferenceServerClient(url=self.triton_url)

    def _load_model(self):
        load_url = (
            f"http://{self.triton_url}/v2/repository/models/"
            f"{self.model_metadata.name}/load"
        )
        response = requests.post(load_url)
_load_model이 하는 일은 로드가 아니라 "로드해달라"는 HTTP 요청입니다. 가중치는 Triton 서버 쪽 메모리에 올라가고 이쪽 프로세스에는 아무 것도 없습니다. 3편 4.2절의 서비스 인프라·비즈니스 로직·모델 실행 세 겹 중, TritonWorker가 모델 실행(Part C)을 전용 서버에 위임하는 실물이고, 이 API 서버는 여전히 캐시 관리(Part B)만 맡습니다.
Triton 서버는 도커로 별도 기동합니다.
docker run -p8009:8000 -p8010:8001 -p8011:8002 \
  -v $(pwd)/model_dir:/models \
  nvcr.io/nvidia/tritonserver:24.12-py3 \
  tritonserver --model-repository=/models --model-control-mode=explicit
컨테이너 안의 HTTP·gRPC·메트릭 세 포트(8000·8001·8002)를 호스트의 8009·8010·8011로 매핑합니다. --model-control-mode=explicit이 붙어야 모델 파일이 있어도 자동 로드하지 않고, 관리 API로 명시적으로 요청할 때만 로드합니다.
테스트에서는 이 서버를 별도 서비스가 아니라 같은 파드의 사이드카 컨테이너로 붙였습니다. TritonWorker.__init__이 0.0.0.0:8009를 하드코딩해 사이드카여야 localhost가 통하고, -v $(pwd)/model_dir:/models도 같은 이유로 두 컨테이너가 같은 PVC를 공유해야 densenet_onnx를 Triton이 찾습니다. gRPC 포트(8001)는 app.server와 겹쳐서 껐고, 컨테이너 안은 tritonserver 프로세스 하나뿐인 블랙박스입니다.
사이드카로 Triton을 붙이면 2.3절의 그 테스트 실패가 해소됩니다 - 결과는 3.2절에서 확인하겠습니다. Triton 이미지는 약 14GB라 처음 받는 데 약 14분이 걸리지만, 노드에 캐시되면 그다음부터는 즉시 뜹니다.
3.2 관리 API와 추론 API
Triton은 HTTP로 두 종류의 API를 내놓습니다. 관리 API(/v2/repository/models/{name}/load, /unload)가 모델을 올리고 내리고, 추론 API(/v2/models/{name}/infer)가 실제 예측 요청을 받습니다. TritonWorker도 _load_model이 관리 API를, predict가 추론 API를 부르는 식으로 이 구분을 그대로 따라갑니다.
predict는 입력을 Triton이 요구하는 텐서 포맷으로 바꾸는 일이 대부분입니다.
def predict(self, input_data: Dict[str, Any]) -> Dict[str, Any]:
    array = np.array(input_data["data"], dtype=np.float32).reshape(input_data["shape"])
    input_tensor = httpclient.InferInput("data_0", array.shape, "FP32")
    input_tensor.set_data_from_numpy(array)

    output_name = "fc6_1"   # DenseNet 전용 하드코딩
    response = self.client.infer(
        model_name=self.model_metadata.name,
        inputs=[input_tensor],
        outputs=[httpclient.InferRequestedOutput(output_name)]
    )
    return {output_name: response.as_numpy(output_name).tolist()}
출력 텐서 이름 fc6_1이 DenseNet 하나만 겨냥해 문자열로 박혀 있어, 모델이 하나 더 생기면 또 하드코딩해야 합니다. 2.2절의 ModelEngine 팩토리 분기와 달리, 위임한 건 실행이지 결과를 해석하는 책임까지 위임되진 않은 셈입니다.
__del__은 워커가 소멸할 때 unload API를 호출해 Triton 쪽 자원을 정리합니다.
def __del__(self):
    try:
        requests.post(f"http://{self.triton_url}/v2/repository/models/"
                       f"{self.model_metadata.name}/unload")
    except:
        pass
except: pass로 에러를 통째로 삼키는 게 의도된 선택입니다. __del__은 가비지 컬렉션 도중 호출되는데, 이 시점에 네트워크 예외가 전파되면 인터프리터 종료 절차가 꼬일 수 있어서입니다.
모델 저장소에 넣는 config.pbtxt는 입력 [3, 224, 224], 출력 [1000]과 배치 설정을 선언합니다.
name: "densenet_onnx"
platform: "onnxruntime_onnx"
max_batch_size: 0
model_dir/densenet_onnx/1/model.onnx처럼 버전 번호 폴더 구조를 따라야 하고, load 요청이 오면 Triton이 이 파일로 입출력을 확인해 가중치를 올립니다. max_batch_size: 0이면 이 데모에서는 Triton의 다이내믹 배칭이 아예 안 쓰입니다. 지금 붙인 건 모델 관리 API와 단발 추론 API뿐이고, 2편의 배칭이나 3편의 continuous batching과는 무관합니다.
cat1.jpg를 224×224로 리사이즈·정규화·CHW 변환해 넣으면 EGYPTIAN CAT(인덱스 285, logit 11.5)으로 분류됩니다 - 로드-추론-언로드 세 API가 맞물려 돈다는 증거입니다. 이걸 검증하는 pytest tests/test_triton_densenet.py를 사이드카와 함께 돌리면 로드·추론·언로드 세 테스트(test_model_loading, test_model_inference, test_model_unloading)가 다 통과하고, 이 셋과 앞서 실패했던 test_image2_triton_model을 함께 돌린 결과가 **4 passed in 13.88s**입니다. 2.3절의 그 실패가 여기서 마저 통과로 바뀌며 두 스위트가 합쳐 전부 통과합니다.
4부. 두 가지 설계
멀티 모델 서빙이 특히 힘을 발휘하는 건 모델은 많은데 전부를 동시에 쓰지는 않을 때입니다. 하루 3-4시간만 도는 예약 처리 작업이라면 모델마다 컨테이너를 띄워두는 대신 필요할 때 불러 쓰면 되고, 고객 1,000명 몫으로 모델 1,000개를 학습시켰어도 최대 200개만 동시 호스팅하도록 제한하고 나머지는 요청 시 그때그때 불러올 수 있습니다. 2부의 LRU 캐시가 정확히 이 상황을 위한 장치입니다.
그래도 과제가 둘 남습니다. 콜드 스타트 지연 - 아직 로드 안 된 모델을 부르면 가중치를 새로 받고 초기화하는 동안 수십 초까지 걸릴 수 있고, 그 요청이 스레드나 커넥션을 오래 붙들면 뒤따르는 요청들이 대기열에 쌓입니다. 핫 모델 확장 - 인스턴스마다 LRU 캐시가 각자의 트래픽만 보고 독립적으로 판단하니, 어떤 모델이 어느 인스턴스에 떠 있는지가 인스턴스마다 다르게 갈립니다. 그 모델을 복제하고 라우팅을 갱신하는 일이 복잡해지고 결과도 매번 조금씩 달라지는 비결정적 동작이 됩니다.
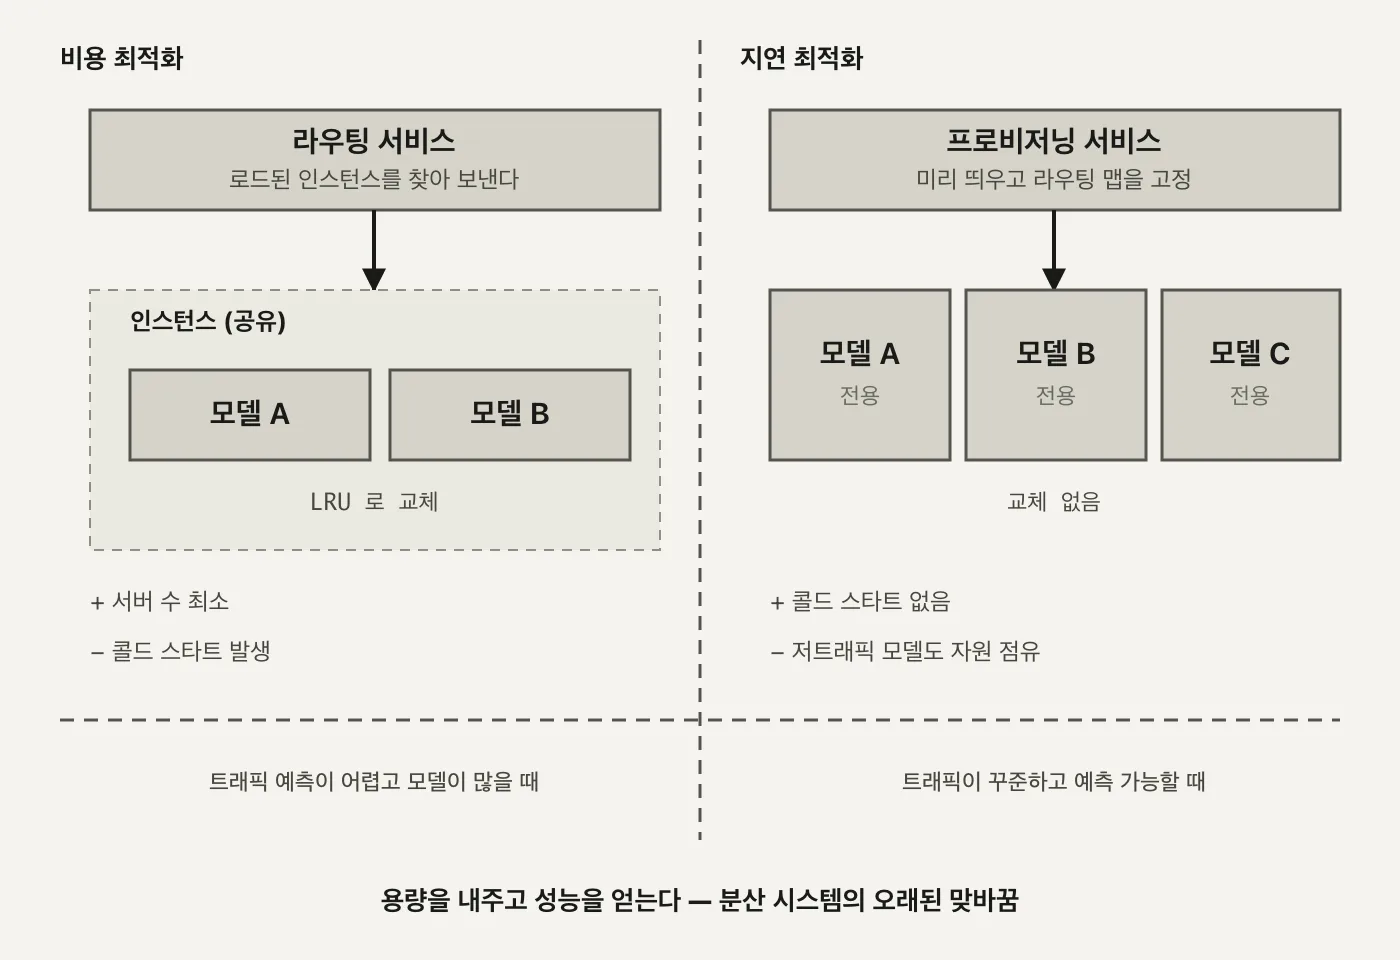
4.1 비용 최적화 - 공유 자원과 동적 라우팅
지금까지 만든 것이 바로 이 설계입니다. 여러 모델이 인스턴스 자원을 공유하고, 요청이 오면 온디맨드로 로드하며(2부의 LRU), 이미 로드된 인스턴스로 동적으로 라우팅합니다. 2부·3부의 ModelManager와 ModelEngine이 인스턴스 한 대 안의 이야기였다면, 이 설계는 그런 인스턴스 여러 대 위에 라우팅 서비스를 얹은 것입니다.
이 상위 라우팅 서비스가 하는 일은 셋입니다. 어떤 모델이 어느 인스턴스에 로드돼 있는지 매핑을 유지하고, 이미 로드된 인스턴스로 요청을 보내 콜드 스타트를 줄이고, 트래픽이 몰리는 모델은 여러 인스턴스에 복제합니다. 신규 모델은 빈 패킹으로 최소한의 서버 수에 몰아 담습니다 - 1.1절의 그 10%·20%·5% 인스턴스에 새 모델을 끼워 넣는 결정입니다.
한계는 반응형이라는 것입니다. 트래픽 급증을 미리 막지 못하고 늘 뒤쫓으며, 라우팅·스케일링·캐시 일관성까지 관리해야 해서 운영 복잡도도 올라갑니다.
4.2 지연 최적화 - 전용 그룹과 사전 프로비저닝
반대 방향의 설계도 있습니다. 모델마다 전용 인스턴스 그룹을 미리 띄워두고, 클라이언트가 예측 요청을 보내기 전에 프로비저닝 서비스를 먼저 불러 라우팅 맵을 갱신한 뒤, 이후 요청은 그 맵을 참조해 정적으로 직행합니다.
두 설계를 나란히 놓으면 자원 배치·로딩 시점·라우팅 방식 셋이 전부 반대로 갑니다.
| 비용 최적화 (4.1) | 지연 최적화 (4.2) | |
|---|---|---|
| 자원 배치 | 여러 모델이 인스턴스 자원을 공유 | 모델마다 전용 인스턴스 그룹을 따로 프로비저닝 |
| 모델 로딩 시점 | 요청 시 온디맨드 (LRU 캐시) | 사전 프로비저닝 - 예측 요청 전에 먼저 호출 |
| 라우팅 | 로드된 인스턴스를 찾아 동적으로 | 라우팅 맵을 참조해 정적으로 |
콜드 스타트가 없고 모델별로 독립 확장되며 캐시 상태를 관리할 필요가 없어 구조가 단순합니다. 4.1절의 한계였던 "핫 모델 확장"도 문제가 아닙니다 - 각 모델이 애초에 자기 전용 그룹을 갖고 있으니 트래픽이 몰려도 그 그룹만 늘리면 됩니다. 단점은 저트래픽 모델도 자원을 계속 점유해 과다 프로비저닝이 생긴다는 것입니다.
분산 시스템에서 흔히 쓰는 용량을 희생하는 대신 성능을 얻는 전략을 지연 최적화 설계가 그대로 따릅니다. 갈림길은 트래픽 예측 가능성입니다 - 예측이 어렵고 모델이 많으면 4.1절의 공유와 동적 라우팅이, 트래픽이 꾸준하면 전용 그룹과 사전 프로비저닝이 맞습니다.
4.3 LLM에서 되풀이되는 구조
LLM은 대개 연산·메모리 요구량이 커서 단일 모델 서빙으로 다루지만, 같은 문제가 두 가지 형태로 다시 나타납니다.
- 프리픽스 캐싱 라우팅 - 같은 프롬프트 프리픽스를 가진 요청을 KV 캐시가 이미 채워진 레플리카로 보냅니다. 중복 계산을 줄인다는 점에서 2.1절의 캐시 히트와 같은 역할입니다.
- 멀티 LoRA 서빙 - 공유 베이스 모델 위에 여러 LoRA 어댑터를 동적으로 올리고 내려, 테넌트별·용도별 개인화를 메모리 효율적으로 확장합니다.
두 케이스 모두 원리는 하나입니다. 무거운 자원(베이스 모델, KV 캐시)은 공유하고, 그 위에 얹는 가벼운 변형이 어느 레플리카에 있느냐로 라우팅한다. 2부의 LRU 캐시가 "어떤 모델을 메모리에 남길지" 정했던 것과, 3부의 Triton이 "실행을 어디에 위임할지" 정했던 것이 결국 같은 질문의 다른 얼굴이었던 셈이고, 어댑터도 GPU 메모리를 무한정 차지할 수 없어 인기 없는 것부터 내리는 정책이 필요하다는 점에서 2.1절의 OrderedDict LRU와 본질적으로 같은 문제입니다.
전체 흐름 정리
요청 도착
    POST /predict {model_id, input_data}                       ← 1.2절

캐시 조회 (ModelManager)
    히트   → move_to_end, 바로 추론                              ← 2.1절
    미스   → ModelStore에서 메타데이터 조회
              캐시가 차 있으면 popitem(last=False)로 LRU 축출
              del + gc.collect() + torch.cuda.empty_cache()     ← 2.4절
              ModelEngine.create_worker(framework 문자열로 분기)   ← 2.2절

추론
    transformers / torchvision  → 이 프로세스 안에서 forward
    triton                      → HTTP로 위임, 결과만 받아온다     ← 3.1~3.2절

응답 반환
세 결정을 한 줄로 줄이면 이렇습니다. 무엇을 메모리에 남길지는 LRU가 정하고, 어떤 코드로 실행할지는 프레임워크 문자열이 정하고, 어디서 실행할지는 위임 여부가 정한다.
네 편을 관통하는 것도 결국 이 하나입니다. GPU라는 자원은 늘 유한하고, 요청은 늘 그 유한한 자원보다 많이 들어옵니다. 1편은 그 자원을 CPU 작업과 나누는 문제였고, 2편은 그 자원 위에서 요청 여럿을 겹쳐 태우는 문제였고, 3편은 그 겹쳐 태우기를 프로덕션 엔진에 맡기는 문제였습니다. 이번 편은 자원을 나누는 대상이 요청이 아니라 모델 자체로 바뀐 것뿐입니다. 어떤 모델을 얼마나 오래 둘지, 어느 프레임워크로 실행할지, 어디로 넘길지 - 전부 "무엇을 우선할 것인가"라는 하나의 질문에서 갈라져 나온, 코드 몇 줄짜리 결정들이 모델 수와 응답 지연, GPU 비용을 좌우합니다.
기억할 숫자 세 개를 정리해 둡니다.
| 숫자 | 뜻 | 왜 중요한가 |
|---|---|---|
| max_models = 2 | ModelManager LRU 캐시의 기본 정원 | 셋을 불러도 loaded_models는 항상 둘로 유지된다 |
| 144줄 (worker.py) | 다섯 파일 중 가장 큰 파일 | 나머지 네 파일(139줄)을 합친 것보다 크다 - 복잡도는 프레임워크 다양성에 몰려 있다 |
| max_batch_size: 0 | Triton config.pbtxt의 배치 설정 |
Triton을 붙여도 다이내믹 배칭은 쓰이지 않는다는 확인 |
막혔던 곳
max_models = 2인데 세 번째 모델을 부르면 뭐가 빠지나? 가장 오래전에 쓰인 것입니다. popitem(last=False)가 OrderedDict의 맨 앞을 뺍니다. 캐시 히트마다 move_to_end로 순서가 갱신되니 "먼저 로드된"이 아니라 "가장 오래 안 쓴"이 기준입니다.
캐시에서 지웠는데 왜 VRAM이 안 줄어드나? 원인이 두 겹입니다. popitem()이 돌려준 워커가 지역 변수에 아직 붙어 있어 객체가 안 죽고, 죽더라도 PyTorch의 caching allocator가 VRAM을 OS에 돌려주지 않습니다. 객체를 버리는 것과 메모리를 회수하는 것은 다른 문제입니다.
Triton에서 "로드"는 무엇을 로드하나? 이 프로세스의 메모리가 아닙니다. Triton 서버에 HTTP로 "그 모델을 올려라"라고 지시하는 것이고, 가중치는 이쪽으로 오지 않습니다. 같은 단어가 한쪽에서는 메모리 적재, 다른 쪽에서는 원격 호출입니다.
test_model_cache가 축출을 실제로 검증하나? 아닙니다. 200 응답과 loaded_models 길이만 단언하고 어느 모델이 빠졌는지는 보지 않습니다. 상한이 지켜지는 것만 확인할 뿐 정책이 맞는지는 검증하지 않습니다.
왜 Triton을 사이드카로 붙였나? 테스트 코드가 0.0.0.0:8009를 하드코딩하고 있어서입니다. 별도 서비스로 띄우면 주소가 맞지 않습니다. gRPC 포트 8001은 app.server와 충돌해서 껐습니다.
max_batch_size: 0인데 Triton의 배칭 기능을 쓰는 건가? 안 씁니다. 이 데모는 Triton의 모델 관리 API와 단발 추론 API만 쓰고 다이내믹 배칭은 꺼져 있습니다. Triton을 붙였다고 배칭이 따라오지는 않습니다.
비용 최적화와 지연 최적화 중 뭘 고르나? 트래픽 예측 가능성이 갈림길입니다. 예측이 어렵고 모델이 많으면 공유와 동적 라우팅이, 트래픽이 꾸준하면 전용 그룹과 사전 프로비저닝이 맞습니다.
출처
- 스터디 교재, Model Serving System Design 3장
- 실습 코드, https://github.com/orca3/llm-model-inference
- Triton Inference Server, https://github.com/triton-inference-server/server
- 멀티 모델 구조와 Triton 연동을 이해하면서 참고한 글 — devlos.tistory.com/128